Let's Encrypt 突发服务中断59分钟:域控制验证失败率飙升,波及全球证书签发
Let's Encrypt 突发服务中断59分钟:域控制验证失败率飙升,波及全球证书签发

2026年9月11日,免费证书大户Let's Encrypt出了个小岔子。根据其官方状态页记录,从发现到解决用时不到一小时。这件事值得聊聊——它让我们看到,当支撑全网无数网站HTTPS加密的"基础设施"出问题时,工程师们是怎么快速排雷的。
说明:本文核心时间线与细节来自用户提供的Let's Encrypt官方状态页截图,网络检索未找到对应的第三方报道或社区讨论帖佐证,因此部分推断性表述已在文中标注,供读者自行判断。
先搞懂一个概念:什么是域名控制验证(DCV)?
简单来说,Let's Encrypt在给你发证书前,得先确认这个域名真的是你的。这个"验明正身"的过程就叫域名控制验证(Domain Control Validation,DCV),通常通过DNS记录查询或HTTP挑战完成。它是发证书的第一道关卡,如果这一步卡住,新证书就发不出来;要是赶上旧证书刚好到期又续不上,网站就可能掉线或被浏览器标记为不安全。所以这道关卡一旦出问题,影响面会很大。
事发经过:不到一小时的时间线
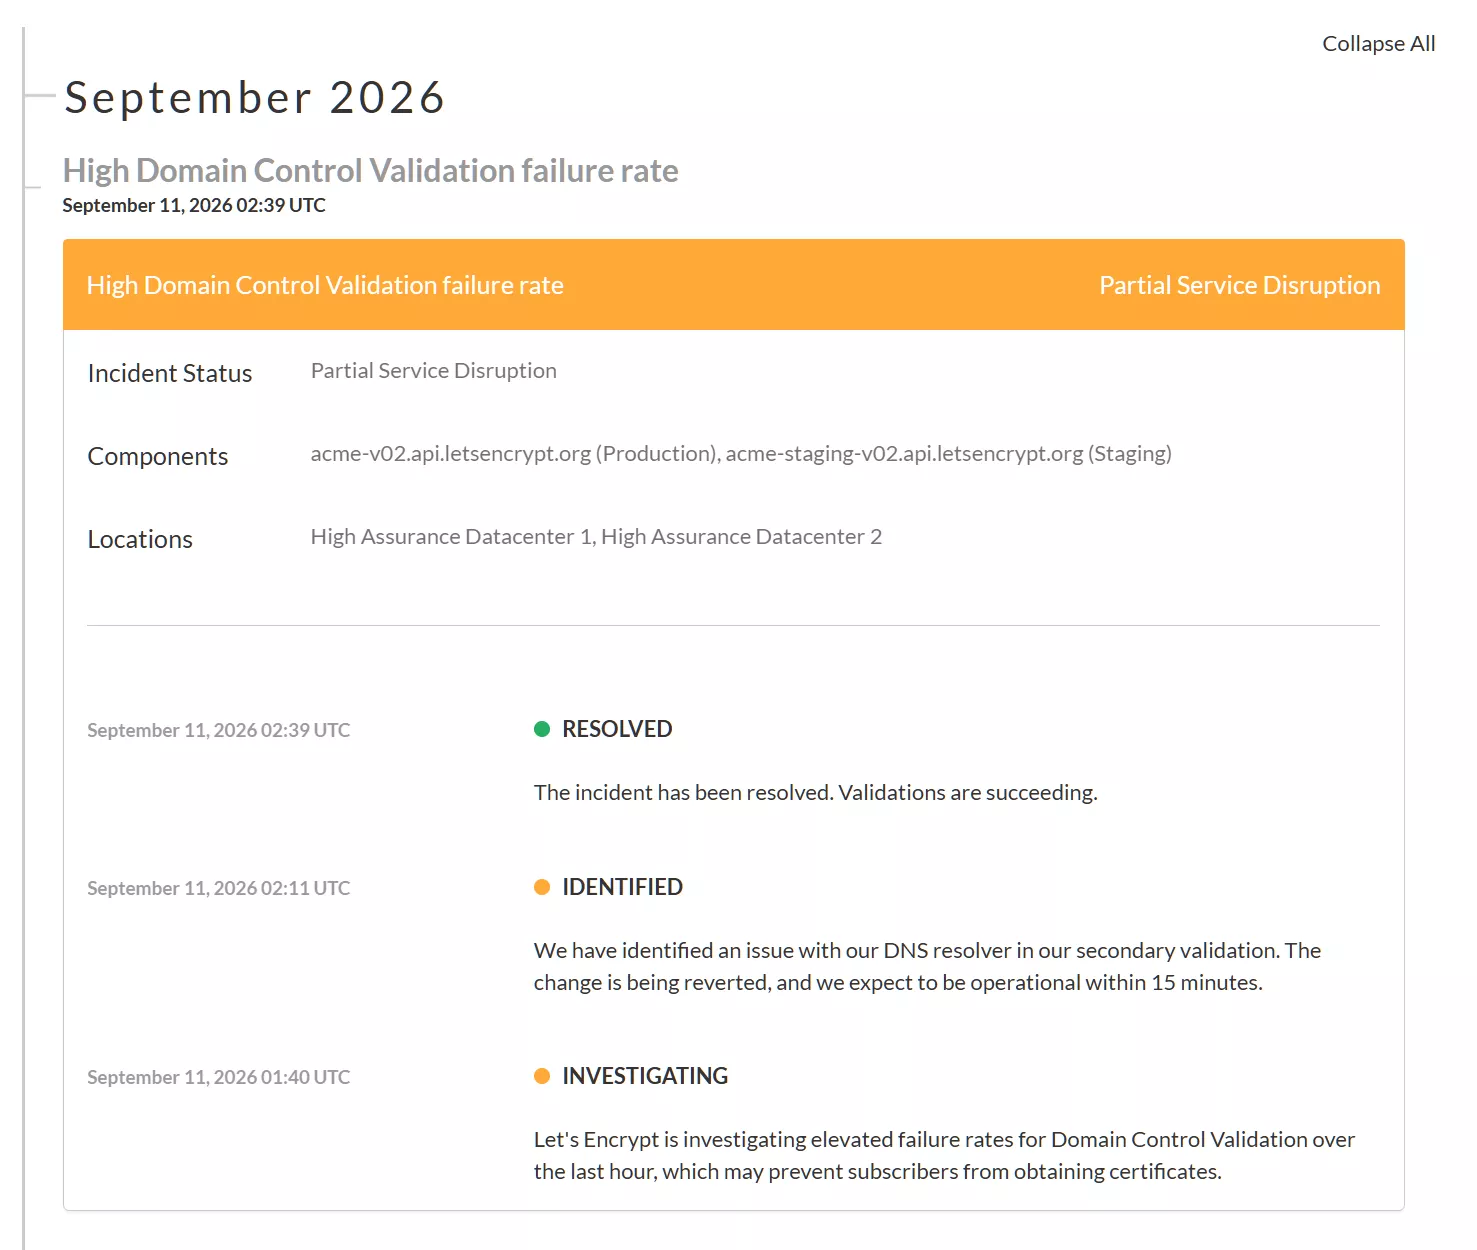
01:40 UTC(北京时间 09:40)— 调查中(Investigating)
官方发布首条公告,称监测到过去一小时内域名控制验证失败率明显升高,并坦言这可能导致部分用户暂时无法获取证书。需要指出的是,这条公告是官方对外发布的第一条消息,不完全等同于内部监控系统最初告警的确切时刻,两者可能存在时间差。
02:11 UTC(北京时间 10:11)— 已定位(Identified)
约31分钟后,团队确认问题出在"辅助验证"(secondary validation)环节所使用的DNS解析器上。为了防止域名劫持类攻击,Let's Encrypt会从多个网络节点分别验证域名归属,这次出问题的是其中一条辅助验证路径。团队随即着手回滚近期变更,并预告约15分钟内恢复正常。这里"核心系统未受影响"是基于公告措辞的合理推测,官方原文并未明确做出这一区分。
02:39 UTC(北京时间 10:39)— 已解决(Resolved)
事件在此关闭,验证功能恢复正常。从"已定位"到"已解决"实际耗时28分钟,比预告的15分钟略长,但仍在一小时的总窗口内完成。
换算说明:本文时间均为UTC+0,按UTC+8(北京时间)需加8小时。整个事件发生在北京时间9月11日上午9:40至10:39之间,恰逢国内工作日早高峰时段。
影响范围
此次事件波及ACME v2的生产端点(acme-v02.api.letsencrypt.org)和测试端点(acme-staging-v02.api.letsencrypt.org),以及两个高保障验证节点("High Assurance Datacenter 1"与"High Assurance Datacenter 2")。官方将其定性为"部分服务中断"(Partial Service Disruption),而非全面瘫痪,因为问题仅出在多视角验证中的一条路径上。
根本原因:一次DNS解析器变更
技术层面最值得关注的一点是,问题被明确定位到"近期一次变更"所引发的DNS解析器故障。这是基础设施故障中相当典型的一类:一次配置调整或版本升级,引入了未预料到的解析异常。既然问题伴随变更出现,团队选择直接回滚而非在线热修复——这是变更嫌疑明确、且追求恢复速度时的常见稳妥做法。
为什么这次应急处理算得上漂亮?
- 反应快,不捂盖子:一小时内即公开承认问题,未等内部流程走完才对外发声。
- 说人话,给预期:每次更新都说明白了故障点、影响范围和大致恢复时间,让下游开发者和自动化脚本能判断是继续重试还是先等待。
- 不乱折腾:选择回滚而非临场修复,降低了"越修越坏"的风险。
- 止损迅速:总耗时不到一小时,将对全网证书自动续期的干扰降到最低。
历史背景:这不是孤立事件
这类"辅助验证节点故障"背后,其实有几层长期存在的结构性原因。
多视角验证(MPIC)本身是应对真实攻击而生的补丁式机制。 Let's Encrypt从多个地理和网络位置分别做DNS验证,正是为了防范攻击者通过篡改路由(如BGP劫持)来欺骗CA、骗取证书。这套机制是CA/Browser论坛在业界发生多起真实劫持事件后强制要求的合规措施。新增的验证节点降低了被攻击的风险,但也天然增加了新的故障点——这次的DNS解析器问题正是这种权衡的体现。
Let's Encrypt自身的故障史并不短。 公开资料显示,类似的签发/验证中断在近几年反复出现,例如:
- 2020年的CAA重新检查漏洞,一次波及约300万张证书的多日运维危机;
- 2025年7月21日的一次完整API中断,事后复盘耗时数天;
- 2026年5月8日因新一代根证书(Generation Y)问题导致签发暂停约2小时28分钟,最终通过回滚至旧的Generation X根证书解决。
可以看出,"出问题就回滚"已经是Let's Encrypt应急响应中反复验证过的固定套路,而非这次事件的临场发挥。
生态高度集中带来系统性脆弱。 据统计,Let's Encrypt每天签发约1000万张证书,覆盖全网约62.7%使用TLS加密的网站。如此高的集中度意味着,即便是几十分钟的局部故障,影响面也会被急剧放大。而随着行业推动证书有效期进一步缩短,CA基础设施的操作余量只会越来越薄,类似的小故障未来可能会更频繁地出现。
给普通运维的启示
大部分服务器使用Certbot等工具自动续期证书,内置了重试机制,这类几十分钟的小故障通常能自行扛过去。但这件事仍然提醒我们:
- 不要把证书续期计划卡在过期前的最后一刻,务必预留缓冲期;
- 平时留意CA的状态页,尤其是自动化运维场景;
- 有条件的话,准备好备选方案(如切换到其他ACME兼容CA,或临时购买商业证书应急)。
毕竟,把关键业务完全押在"别人的基础设施永远不出错"这个假设上,并不现实。
总结
这次事件本身规模不大,但过程体现了扎实的运维功底:一个DNS层面的小故障,一小时内完成定位、回滚与恢复,全程公开透明沟通。对于一家靠"信任"维系运转的机构而言,这种靠谱的应急响应能力,本身就是对整个Web安全生态最大的负责。同时,把这次事件放进Let's Encrypt过去几年的故障史里看,也提醒我们:基础设施的高可用,从来不是一劳永逸的结果,而是一场持续的、需要不断权衡取舍的工程实践。
文档信息
- 文章作者:运维技术团队 - Devin
- 发布日期:2026-09-11
- 适用平台:ALL
- 参考链接:https://letsencrypt.status.io/pages/history/55957a99e800baa4470002da
如果本文对你有帮助,欢迎点赞、在看、转发,让更多开发、运维同学们看到!